
Descargo de responsabilidad:
Este blog (www.miprofemetienemania.com) es un blog de divulgación, en ningún caso se pretende dar ningún consejo de estilo de vida o inversión monetaria o de cualquier otra índole.
Las decisiones importantes se deben tomar después de un período individual de reflexión seria y profunda, y la libertad de tomar unas u otras implica la asunción de la responsabilidad de sus efectos.
Haz lo que quieras, pero bajo tu propia responsabilidad.
Hace unos días, en una notificación de las que te aparecen en YouTube alguien estaba diciendo —o eso es, al menos, lo que creo recordar— «El Franco Suizo y el Euro siguen un patrón cíclico en su cotización».
Como a mí siempre me ha parecido que la evolución de las cotizaciones es de todo menos predecible (acciones, monedas…) esa afirmación me llamó la atención y me dije: «¿¿a ver si va a ser verdad??»
Por lo que me dispuse a averiguarlo. Al fin y al cabo no soy economista pero sí conozco algo de matemáticas.
¿Qué me he preguntado?
Las preguntas que me hice son:
- ¿Realmente la cotización del Franco Suizo (CHF) y del Euro (EUR) siguen un patrón de cotización regular, predecible y cíclico?
- ¿Cómo podría averiguarlo mediante datos y gráficos?
- ¿Existe algún lugar donde pudiese encontrar todos estos datos?
- y si existe y puedo acceder a los datos ¿cómo los manejo?
Hace mucho, mucho que en el Máster de Estadística Aplicada de la UNED me tocó estudiar un tema sobre series temporales, así que me dije que era un buen momento para recordar esos procesos y además investigar si lo que alguien decía era verdad o no.
De esta manera mataba dos pájaros de un tiro: recordar técnicas estadísticas avanzadas y por otro satisfacer mi curiosidad.
¿Qué he ido haciendo?
La primera pregunta a resolver es ¿De dónde saco yo estos datos?
Sabía en en Yahoo Finanzas hay cotizaciones de muchos activos y que en general debían ser datos más bien públicos y accesibles. Al fin y al cabo se trata de dos monedas internacionales bastante importantes y que no debía ser muy complicado encontrar.
No se trataba de memecoins, o de monedas de un pseudopaís como podría ser Osetia del sur o Abjasia.
Y sí. Encontré los datos en el propio ¡¡Banco Central Europeo!!
o fue excesivamente fácil encontrarlos pero tampoco fue complicado.
Cómo obtener datos del BCE mediante su API
No sé muy bien qué es una API, aunque por lo que he ido viendo durante varios años es una parte de la web a la que te puedes conectar y descargar o interactuar con datos. Si algún informático o alguien que lea esto se anima a decirnos qué es una API, por favor, que use los comentarios de la entrada.
Preparando R
Lo que debía hacer es usar el programa informático R que te puedes descargar desde cran.r-project.org/. Este programa me gusta. Me gusta mucho. No es sencillo de aprender, pero es una pasada lo que puedes llegar a hacer con ello.
Pero había que buscar qué tenía que teclear.
Todo lo que haremos en esta entrada se hará sin la necesidad de cargar ninguna librería (esto es, sin la necesidad de cargar en R ningúna herramienta adicional que nos permita hacer el análisis).
Descargando datos
Una vez que tengamos esto, vamos a hacer una llamada al BCE para que nos dé todos los datos de los que dispone de la cotización CHF/EUR desde el 01-01-1999. Pongo ese día pues el el «nacimiento» del euro, pero el primer día disponible es el de cuatro de enero. Para nuestro caso da igual, luego veremos que hay más de 60 valores faltantes así que dos o tres días más no tiene mayor importancia. Además, a día de hoy (15-10-2026) han pasado casi 28 años.
Faltan algunos valores porque por la razón que sea BCE no tiene esa cotización publicada: podrían ser festivos como en año nuevo o por cualquier otra razón. No obstante desde el 01-01-99 hasta hoy han pasado unos 10150 días. Considero que tener unos pocos días faltantes no van a entorpecer ni la explicación del método ni las conclusiones. No obstante, si faltasen datos que consideráramos importantes ya veríamos cómo podríamos solucionarlo o completarlo con otras bases de datos.
De momento como te acabo de decir, no le damos más importancia, al fin y al cabo, lo que pretendo con esta entrada es mostrar técnicas estadísticas desde las más básicas (mirar un gráfico, aquí) hasta otras más complejas (series temporales [[Proximamente]])
Así que vamos a empezar. Lo primero es descargar los datos y para ello usamos este comando (en R todo lo que va después de # es un comentario, lo puedes escribir y R lo ignorará):
# Descargar los datos del Banco Central Europeo

url <- paste0(
  "https://data-api.ecb.europa.eu/service/data/",
  "EXR/D.CHF.EUR.SP00.A?",
  "startPeriod=1999-01-01&format=csvdata"
)

datos <- read.csv(url)

# Copia dentro de la sesión de R
copia.seguridad <- datos

# Copia permanente en el disco
write.csv2(
    datos,
    file = "copia_de_seguridad.csv",
    row.names = FALSE
)
Con todo esto le hemos dicho a R lo siguiente:
- url «Mira, te voy a copiar en el archivo url una dirección web para cuando la necesite. En esta url puedes descargarte los datos de cotización CHF y EUR desde el día 01-01-1999, cuando se los pidas, que te los de en formato csv.
- datos «Usa el objeto url para que BCE te dé todos los datos y guárdalos en datos en formato cvs» Esto no te va a crear un archivo datos.cvs en el ordenador. Solo te lee la cotización y te los guarda R en su sistema como si hubiese leído un cvs.
- copia.seguridad «haz una copia de datos y guárdalo como copia.seguridad» Esto no es 100% necesario, al fin y al cabo podríamos llamar al BCE tantas veces como queramos, pero ahora dime ¿y si se te cae la web? imagina que estás en un ferry yendo Valencia–Mallorca, es posible que no tengas acceso a Internet, puedes tener los datos accesibles siempre y trabajar con ellos.
Por otro lado, si das una instrucción que corrompe tus datos, lo único que debes hacer es volver a cargarlos (es una faena, pero recuperable). - write.csv2 Con esta orden le decimos a R Todos los datos que te acabas de descargar del BCE guárdalos en el disco del PC en el archivo
copia_de_seguridad.cvs. Es otra medida de seguridad sobre los datos. El archivo datos lo guarda R en la sesión, perocopia_de_seguridad.cvsse guarda en tu ordenador.- ¿Cómo puedes saber dónde lo guarda? ejecuta
copia_de_seguridad.cvsy sabrás en qué directorio está (getwd()= get work directory = dame el directorio de trabajo)
- ¿Cómo puedes saber dónde lo guarda? ejecuta
Análisis exploratorio y preparación de datos en R
Ahora vamos a hacer un análisis exploratorio, ¿qué es eso? pues es mirar a ver qué tipo de datos tenemos, cuántos de cada tipo, y ver si hay que limpiar y ordenar los datos.
Son pocos y ‘poca cosa’, así que la limpieza será sencilla.
En principio vamos a ver qué datos tenemos, Queremos saber cuántas filas, cuántas columnas y qué hay en cada columna. Para ello ejecutamos:
dim(datos)
[1] 7182   32

names(datos)
 [1] "KEY"             "FREQ"            "CURRENCY"        "CURRENCY_DENOM"
 [5] "EXR_TYPE"        "EXR_SUFFIX"      "TIME_PERIOD"     "OBS_VALUE"
 [9] "OBS_STATUS"      "OBS_CONF"        "OBS_PRE_BREAK"   "OBS_COM"
[13] "TIME_FORMAT"     "BREAKS"          "COLLECTION"      "COMPILING_ORG"
[17] "DISS_ORG"        "DOM_SER_IDS"     "PUBL_ECB"        "PUBL_MU"
[21] "PUBL_PUBLIC"     "UNIT_INDEX_BASE" "COMPILATION"     "COVERAGE"
[25] "DECIMALS"        "NAT_TITLE"       "SOURCE_AGENCY"   "SOURCE_PUB"
[29] "TITLE"           "TITLE_COMPL"     "UNIT"            "UNIT_MULT"
Esto nos está indicando que tenemos un total de 7182 filas y 32 columnas cuyos nombres, en principio, no nos dicen nada.
¿Cómo solucionamos esto? Bueno esta entrada es sólo de cómo trabajar con R y con datos reales y no quiero, por tanto, meterme, en el estudio pormenorizado de cada columna. Si quieres saber qué significa cada cosa el BCE te lo explica aquí y también aquí.
Si quieres hacer otra visualización de los datos puedes teclear la instrucción str() de R , con eso obtenemos lo siguiente:
str(datos)
'data.frame':	7182 obs. of  32 variables:
 $ KEY            : chr  "EXR.D.CHF.EUR.SP00.A" "EXR.D.CHF.EUR.SP00.A" "EXR.D.CHF.EUR.SP00.A" "EXR.D.CHF.EUR.SP00.A" ...
 $ FREQ           : chr  "D" "D" "D" "D" ...
 $ CURRENCY       : chr  "CHF" "CHF" "CHF" "CHF" ...
 $ CURRENCY_DENOM : chr  "EUR" "EUR" "EUR" "EUR" ...
 $ EXR_TYPE       : chr  "SP00" "SP00" "SP00" "SP00" ...
 $ EXR_SUFFIX     : chr  "A" "A" "A" "A" ...
 $ TIME_PERIOD    : chr  "1999-01-04" "1999-01-05" "1999-01-06" "1999-01-07" ...
 $ OBS_VALUE      : num  1.62 1.61 1.61 1.62 1.61 ...
 $ OBS_STATUS     : chr  "A" "A" "A" "A" ...
 $ OBS_CONF       : logi  NA NA NA NA NA NA ...
 $ OBS_PRE_BREAK  : logi  NA NA NA NA NA NA ...
 $ OBS_COM        : logi  NA NA NA NA NA NA ...
 $ TIME_FORMAT    : chr  "P1D" "P1D" "P1D" "P1D" ...
 $ BREAKS         : logi  NA NA NA NA NA NA ...
 $ COLLECTION     : chr  "A" "A" "A" "A" ...
 $ COMPILING_ORG  : logi  NA NA NA NA NA NA ...
 $ DISS_ORG       : logi  NA NA NA NA NA NA ...
 $ DOM_SER_IDS    : logi  NA NA NA NA NA NA ...
 $ PUBL_ECB       : logi  NA NA NA NA NA NA ...
 $ PUBL_MU        : logi  NA NA NA NA NA NA ...
 $ PUBL_PUBLIC    : logi  NA NA NA NA NA NA ...
 $ UNIT_INDEX_BASE: chr  "99Q1=100" "99Q1=100" "99Q1=100" "99Q1=100" ...
 $ COMPILATION    : logi  NA NA NA NA NA NA ...
 $ COVERAGE       : logi  NA NA NA NA NA NA ...
 $ DECIMALS       : int  4 4 4 4 4 4 4 4 4 4 ...
 $ NAT_TITLE      : logi  NA NA NA NA NA NA ...
 $ SOURCE_AGENCY  : chr  "4F0" "4F0" "4F0" "4F0" ...
 $ SOURCE_PUB     : logi  NA NA NA NA NA NA ...
 $ TITLE          : chr  "Swiss franc/Euro ECB reference exchange rate" "Swiss franc/Euro ECB reference exchange rate" "Swiss franc/Euro ECB reference exchange rate" "Swiss franc/Euro ECB reference exchange rate" ...
 $ TITLE_COMPL    : chr  "ECB reference exchange rate, Swiss franc/Euro, 2.15 pm (C.E.T.)" "ECB reference exchange rate, Swiss franc/Euro, 2.15 pm (C.E.T.)" "ECB reference exchange rate, Swiss franc/Euro, 2.15 pm (C.E.T.)" "ECB reference exchange rate, Swiss franc/Euro, 2.15 pm (C.E.T.)" ...
 $ UNIT           : chr  "CHF" "CHF" "CHF" "CHF" ...
 $ UNIT_MULT      : int  0 0 0 0 0 0 0 0 0 0 ...
¿Qué es cada cosa?
- data.frame: esto es la clase de datos. Lo puedes interpretar como que un data.frame es una matriz o una tabla enriquecida donde pueden convivir datos de distinto tipo: numéricos, caracteres, lógicos….
- Cada una de las filas precedidas por $ hace referencia a cada uno de las columnas del data.frame.
- La primera parte es tan solo el nombre de la columna
- Después de los dos puntos «:» (crh, num, logi, int) indica el tipo de dato que codifica esa columna. Ahora vamos con ello.
- Por último R te ofrece los primeros datos de cada columna
Así que con esta instrucción vemos qué es lo que tenemos.
Pero te he dejado algo a medias. Para la variable $TIME_PERIOD R nos indica que es un chacarcter (caracteres, letras, texto en definitiva). Hay que decirle a R que eso son fechas y por tanto las debe codificar como tal. Usamos este comando:
datos$TIME_PERIOD<-as.Date(datos$TIME_PERIOD)
Así le decimos a R, la columna «fecha» modifícala. Toma los datos que ya tienes ahí y conviértelos en fechas.
También tenemos un problema con la columna OBS_CONF. Lo que nos ha ocurrido es que R lo ha interpretado como FALSE/TRUE. Esto es debido a que el BCE nos ha ofrecido ahí una serie de F que no es una estructura lógica si no que esos datos no están sujetos a confidencialidad (es uno de los tipos de confidencialidad que maneja el BCE). Por tanto hay que cambiarlos también.:
datos$OBS_CONF <- ifelse(
is.na(datos$OBS_CONF),
NA_character_,
"F"
)
Con esta instrucción le decimos a R: la columna de confidencialidad la debes codificar como NA (no disponible: not available) si no hay nada o bien como F (todos estos datos son F y R lo ha leído como FALSE)
Sobre este código habría que hacer una salvedad, imagina que hay datos F y T que R los interpreta como FALSE y TRUE, en este caso podríamos «enlazar» varios ifelse, como en el caso siguiente (este bloque de código que te doy debes ejecutarlo sobre los datos originales, no sobre los que acabas de cambiar):
datos$OBS_CONF <- ifelse(
    is.na(datos$OBS_CONF),
    NA_character_,
    ifelse(
        datos$OBS_CONF == FALSE,
        "F",
        "T"
    )
)
Y así puedes enlazar hasta conseguir depurar todos los posibles casos de las columnas. Lo importante es que R te lo hace de una sentada y no necesitas ir revisando las miles de líneas de datos una a una.
Podríamos, quizá, seguir analizando alguna columna más, pero creo que con esto te he dado herramientas par que tú puedas modificar datos que te descargues.
Así que ahora vamos a seleccionar aquellos datos con los que vamos a trabajar. Es absurdo usar una matriz de datos de 32 columnas, cuando realmente necesitamos 2: TIME_PERIOD y OBS_VALUE.
# Extraer las fechas y cotizaciones
fecha <- as.Date(datos$TIME_PERIOD)
cambio <- as.numeric(datos$OBS_VALUE)

# Ordenar cronológicamente
orden <- order(fecha)

fecha <- fecha[orden]
cambio <- cambio[orden]
Los dos primeros códigos le indica a R:
- Toma los datos que aparecen en la columna TIME_PERIOD, y almacénalos en ‘fecha’.
- Toma los datos de la columna OBS_VALUE, y una vez que los conviertas a números almacénalos en ‘cambio’
Luego le decimos a R: «ordéname todas las fechas por orden»
En las dos últimas lineas le decimos a R que nos ordene los datos según las fechas.
Representar la cotización EUR/CHF en R
Por último en esta entrada le damos a R la orden de generar un gráfico con estos datos mediante este código:
# Representación gráfica
plot(
  fecha,
  cambio,
  type = "l",
  col = "blue",
  lwd = 1,
  main = "Evolución histórica EUR/CHF (1999-2026)",
  xlab = "Año",
  ylab = "Francos suizos por euro"
)

grid()
Y el gráfico que obtenemos es este:
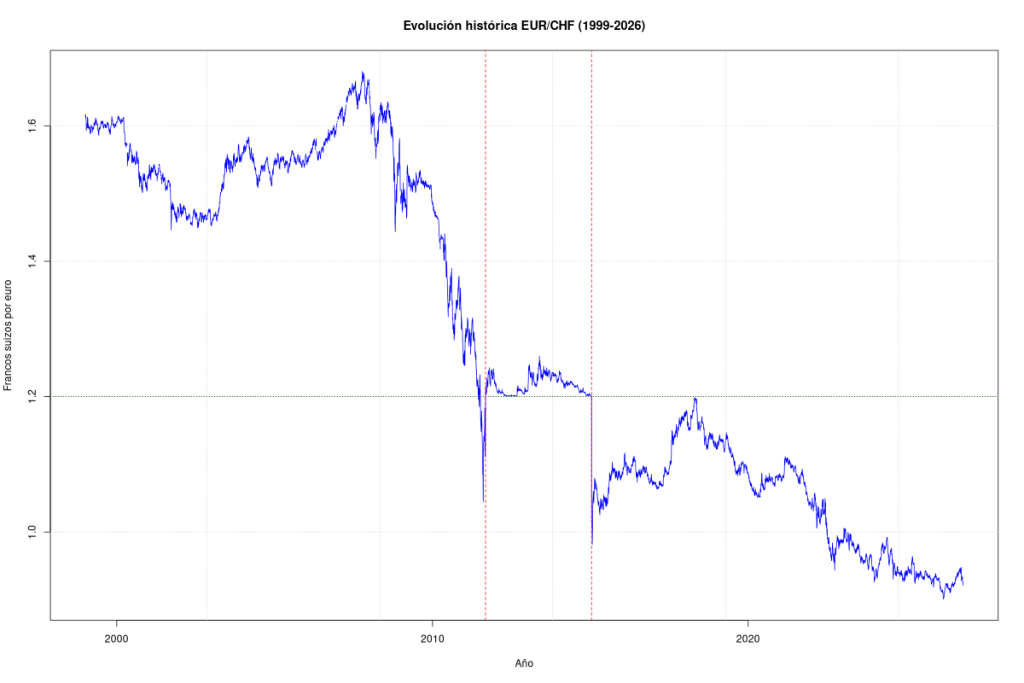
En este gráfico se pueden ver varias cosas:
- No parece, en absoluto, que la cotización EUR/CHF sea cíclica, más bien lo que ha ocurrido es que el EUR cada vez vale menos con respecto al CHF.
- He marcado 3 rectas, Las verticales son el período de 06-09-2011 a 15-01-2015 en el cual el Banco Central Suizo sí intervino el precio de su divisa y fijó un cambio mínimo de 1.20 CHF/EUR (linea horizontal).
El código que debes usar para ello es este
abline(
v = as.Date("2011-09-06"),
col = "red",
lty = 2
)

abline(
v = as.Date("2015-01-15"),
col = "red",
lty = 2
)

abline(
h = 1.20,
col = "darkgreen",
lty = 3
)
- Fuera de este período intervenido, lo que se ve (a ojo) es una tendencia en la que el EUR pierde valor con respecto al CHF
Con esto tenemos una primera conclusión visual: no parece que el cambio EUR/CHF siga una patrón cíclico. Más bien parece que el CHF se ha ido apreciando con respecto al EUR.
Continúo el análisis
Si quieres ver cómo continúo el análisis puedes pinchar pincha aquí. en la siguiente entrada donde seguimos este estudio usaremos la librería quantmod que instalaremos al principio.
Empezaremos por técnicas estadísticas más o menos sencillas (recta de regresión y polinomio de regresión) y acabaremos por ténicas más complejas como son las series temporales.
Deja una respuesta